Transformer เบื้องหลังความสามารถของ LLM
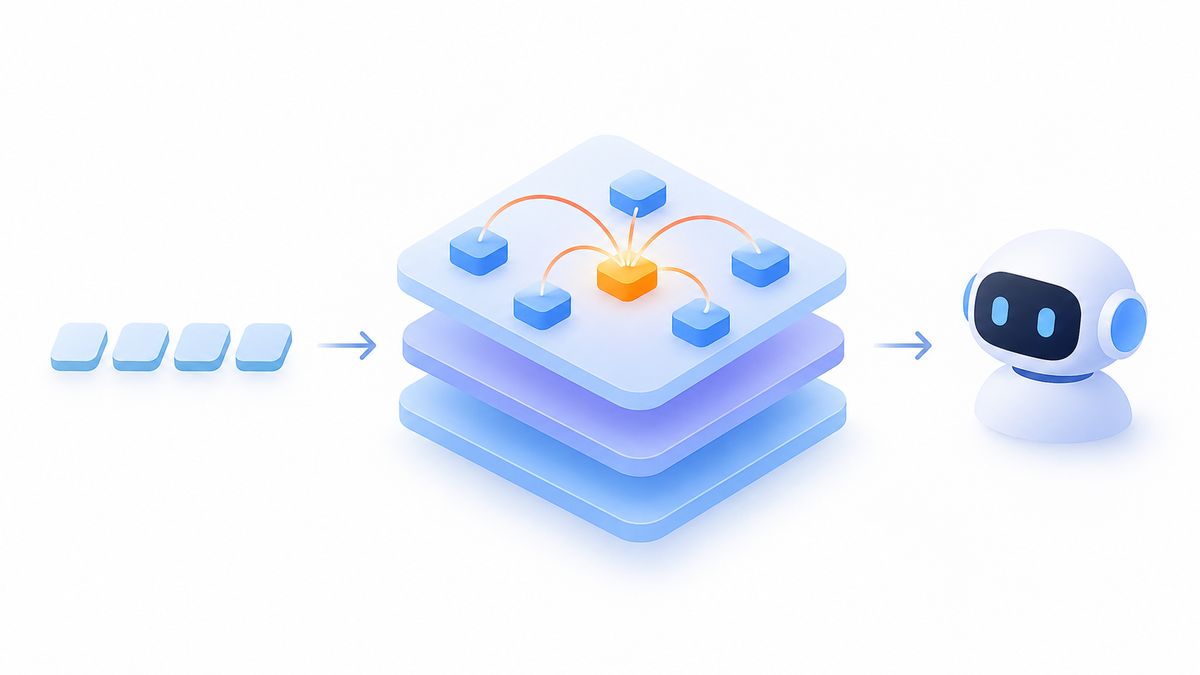
หาก Token คือ หน่วยย่อยของข้อความ และ Embedding คือ การแปลง Token ให้เป็นตัวเลขที่สะท้อนความหมาย Transformer ก็คือ สถาปัตยกรรมที่ช่วยให้ LLM เรียนรู้ความสัมพันธ์ระหว่างคำ เข้าใจบริบท และสร้างข้อความได้อย่างมีประสิทธิภาพ
Transformer เป็นเทคโนโลยีสำคัญที่อยู่เบื้องหลัง LLM ถูกพัฒนาขึ้นเพื่อแก้ข้อจำกัดของโมเดลรก่อนหน้านี้อย่าง RNN และ LSTM ซึ่งประมวลผลข้อมูลตามลำดับ ทำให้การจัดการข้อความที่ยาวและความสัมพันธ์ระหว่างคำที่อยู่ห่างกันทำได้ยาก
หลักสำคัญของ Transformer คือ Self-Attention ซึ่งช่วยให้โมเดลพิจารณาความสัมพันธ์ระหว่างคำต่าง ๆ ในประโยค และรู้ว่าคำใดมีความสำคัญต่อการทำความเข้าใจบริบท
กลไก Attention ทำงานผ่านองค์ประกอบ 3 ส่วน ได้แก่ Query, Key และ Value โดยเปรียบง่าย ๆ คือ Query เป็นสิ่งที่ต้องการค้นหา Key เป็นข้อมูลที่ใช้จับคู่ความสัมพันธ์ และ Value เป็นข้อมูลที่นำมาใช้เมื่อพบสิ่งที่เกี่ยวข้อง
นอกจากนี้ Transformer ยังมี Multi-Head Attention ที่ช่วยให้โมเดลมองความสัมพันธ์ของคำได้หลายมุมมองพร้อมกัน และมี Positional Encoding เพื่อบอกตำแหน่งของคำว่าอะไรอยู่ก่อนหรือหลัง เพราะการประมวลผลแบบ Transformer ไม่ได้เข้าใจลำดับคำโดยอัตโนมัติ
ภายใน Transformer ยังมีส่วนที่เรียกว่า Transformer Block ซึ่งประกอบด้วย Attention สำหรับเรียนรู้ความสัมพันธ์ของข้อมูล และ Feed Forward Network สำหรับประมวลผลข้อมูลเพิ่มเติม โดยมีการทำงานร่วมกันหลายชั้นเพื่อสร้างความเข้าใจที่ซับซ้อนขึ้น
สำหรับ GPT นั้น ใช้สถาปัตยกรรมที่เรียกว่า Decoder-only Transformer ซึ่งออกแบบมาเพื่อทำนาย Token ถัดไปจากข้อความที่ได้รับ แล้วทำซ้ำไปเรื่อย ๆ จนกลายเป็นประโยคหรือข้อความที่สมบูรณ์
แนวคิด Transformer จึงเป็นรากฐานสำคัญของ LLM ในปัจจุบัน ไม่ว่าจะเป็น GPT, Claude, Gemini หรือ Llama แม้แต่ละโมเดลจะมีรายละเอียดการออกแบบและการพัฒนาที่แตกต่างกัน แต่ต่างก็ได้รับอิทธิพลจากสถาปัตยกรรม Transformer
สรุป
Transformer คือ เทคโนโลยีที่ทำให้ LLM สามารถเรียนรู้ความสัมพันธ์ระหว่างคำ เข้าใจบริบทของภาษา และสร้างข้อความได้อย่างมีประสิทธิภาพ โดยมี Self-Attention เป็นกลไกที่ทำให้ความสามารถเหล่านี้เกิดขึ้นได้
