ทำไม Embedding จึงสำคัญกับ LLM?
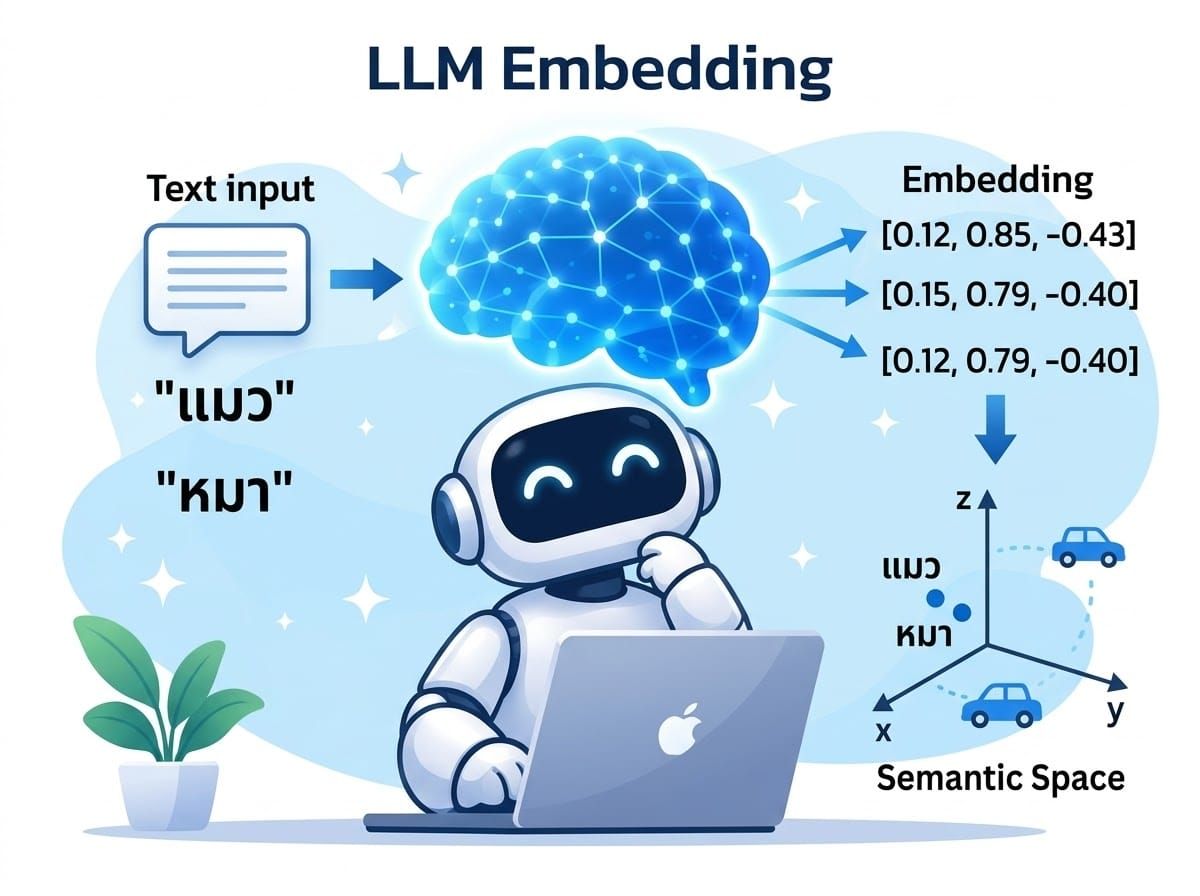
สามารถเข้าใจเรื่อง Embedding ได้ เพียงจำ 5 เรื่องสำคัญนี้
- LLM ประมวลผลข้อความผ่านหน่วยย่อยที่เรียกว่า Token
- Token สามารถแปลงเป็น Embedding ได้
- Embedding คือ Vector หรือตัวเลขที่ใช้แทนความหมายของคำหรือข้อความ
- ข้อความที่มีความหมายใกล้เคียงกัน มักมีตำแหน่ง Vector อยู่ใกล้กัน
- แนวคิดนี้เป็นพื้นฐานของ Semantic Search, Vector Database และ RAG
ตัวอย่างการใช้งาน
ลองนึกถึงธุรกิจที่มีข้อมูลจำนวนมาก ทั้งข้อมูลลูกค้า ผลิตภัณฑ์ และเอกสารภายในองค์กร
Embedding ช่วยให้ LLM ค้นหาข้อมูลเหล่านี้จากความหมายได้ ไม่ใช่แค่ค้นหาจากคำที่ตรงกัน เช่น
- Customer Insight Copilot
- Product Recommendation Search
- Internal Knowledge Search
- Policy Q&A Bot
เบื้องหลังกระบวนการเหล่านี้มีแนวคิดคล้ายกัน คือ
Document >> Embedding >> Vector Database >> Similarity Search >> GPT >> Answer
เมื่อเข้าใจ Embedding เราก็จะเข้าใจพื้นฐานสำคัญของ RAG และการนำ LLM มาใช้กับข้อมูลภายในองค์กรได้ง่ายขึ้น
Embedding คือการแปลงคำหรือเอกสารให้เป็น Vector ที่แทนความหมาย เพื่อให้ LLM สามารถค้นหาข้อมูลจากสิ่งที่มีความหมายใกล้เคียงกันได้ ไม่ใช่แค่คำที่เหมือนกันเท่านั้น